外观
文本转语音tts
23 秒超时提醒(阿里云实时语音合成的限制)
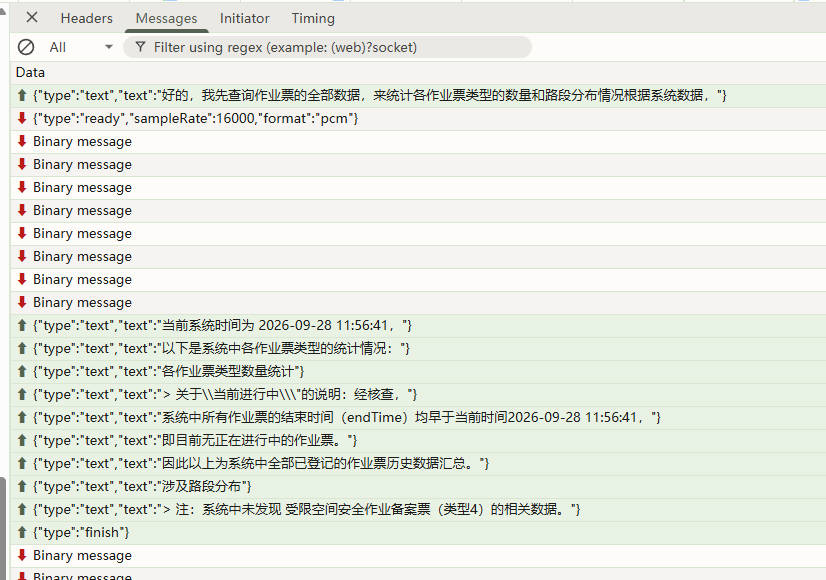
本页的流式语音播报依赖阿里云百炼实时语音合成,该服务存在 23 秒 的超时限制:一次合成会话中若在 23 秒内没有新的文本送入,服务端会主动断开连接。
- 影响:如果后端 LLM 接口思考(推理)时间过长,超过 23 秒仍未产出可播报的文本,实时合成会话会先超时断开(
InvalidParameter: request timeout after 23 seconds),导致 TTS 转换中断、数字人播报中途停止(后半段回答没有声音)。 - 说明:该超时来自阿里云服务侧(详见 百炼实时语音合成用户指南),属于服务本身的约束,应用层无法直接取消。
- 规避(已实现,在后端):
AliyunRealtimeTtsBridge内置「空闲保活」看门狗——距上次真正投喂文本超过aihuman.tts.aliyun.realtime.idle-keep-alive-ms(默认 15000,即 15s)就补发一段idle-keep-alive-text(默认『。』)当保活帧,只为重置服务端的空闲计时,不改动本轮文本内容、前端零改动。用句末标点而非逗号/顿号,是因为软标点会被服务端"攒批"等更多文本、反而不回流。把idle-keep-alive-ms设为0即可关闭该机制;日志关键字空闲 …ms 未投喂文本,补发保活帧。 - 仍需优化根因:保活只保证"连接不断",用户在听感上仍要等 LLM 的首字延迟;建议同步优化后端 LLM 的首字 / 分段延迟,或在长等待时先播一句本地预生成 mp3 过渡话术(如"稍等,正在为您查询")。
本页聚焦「大模型回答如何流式呈现」与「语音能力如何配合」,是大屏体验的两大亮点。
一、SSE 解析(utils/sse.js)
parseSSEEvents(chunk, buffer, pendingEvent) 具备工业级容错:
- 跨 chunk 行缓冲:TCP 分包可能截断行,凑齐
\n才消费; event:与data:跨 chunk:用pendingEvent传递事件类型,避免类型丢失;- 三种流格式兼容:标准 SSE(
event:+data:)、仅data:行(event 在 JSON 内)、type{json}类型前缀(无data:前缀); - 流结束后消费
buffer中最后一行残留。
两种实现并存:streamAiChatReply(智能交互,手写行解析 + 若依包装解包 + deepFind 递归取 timeCost/sessionId)与 handleSSEStream(专家问答,复用 parseSSEEvents)。两者都在 finally 中 reader.cancel() 主动关闭底层连接,避免后端保持长连接导致 read() 永久挂起。
实现位置(会话核心已拆分为组装层 +
core/模块,见前端项目结构):streamAiChatReply在core/aiChatStream.js,handleSSEStream在core/expertChat.js,parseLooseObject/deepFind在core/sseParse.js。
二、Markdown 渲染(VaMessageItem.vue / MobileMessageItem.vue,双端同构)
渲染链路:marked(GFM + breaks)→ DOMPurify.sanitize(XSS 防护)→ 链接注入 target="_blank" rel="noopener noreferrer"。
针对大模型输出做了三项定制:
- 宽松加粗扩展
looseStrong:CommonMark 规定闭合**前为标点(如全角括号)时不能关闭强调,导致星号原样显示。扩展用宽松正则识别成对**...**并优先于内置规则生效。 - 表格语法归一化
normalizeTableSyntax:- 全角
|→ 半角|,分隔行内全角横线/冒号归一化; - 压缩表格修复:SSE 拼接常把整张表挤成一行,算法按分隔行向上找表头、向下找数据行,重建标准多行表格;
- 标题规范化:段中
###前补换行、行首###后补空格。
- 全角
- 样式适配:表格
table-layout: fixed锁宽(列内容换行,不撑出横向滚动条)、代码块max-width:100%+ 内部横向滚动、消息容器min-width:0允许 flex 压缩。
消息类型
| 类型 | 渲染 |
|---|---|
user | 右对齐纯文本气泡(移动端同样不渲染 Markdown) |
assistant | 左头像 + Markdown 气泡 |
assistant + subtype: 'search' | 可折叠引用卡片(默认折叠,点击展开引用列表) |
system | 居中提示(模式切换、配对成功、超时、错误等) |
tool | 已入库并通过 VaToolMessage.vue 提供卡片(调用中/成功/失败三态 + JSON 展开),当前列表渲染处为注释状态,作为能力预留 |
三、语音播报策略(边收边播 / 全文 / 本地优先)
实现位置:增量队列与整段序列播放(
enqueueAudio/runAudioQueue/playTTSSequence/cancelTTS)在core/speech.js;智能交互的边收边播与双工节流投喂在core/aiChatStream.js(投喂状态与常量在core/duplex.js);系统导览的分段播放与段间预投喂在core/demoTour.js。
双工链路时序(
utils/audio.js):文本与finish都等后端回ready(阿里云 task-started)之后再下发,保证文本帧一定先于 finish 帧;本轮从未投喂过文本时不发finish(否则服务端会回InvalidParameter: Please ensure input text is not empty,整轮降级为/tts/aliyun整段播报,该非流式链路即将弃用)。相关日志:[TTS][duplex] 通道已连接,等待服务端 ready 后再投喂文本/开始投喂文本(N 片 / M 字)/文本投喂结束:共 N 字,下发 finish。
大模型输出含大量 Markdown,直接朗读体验极差,前端在朗读前做清洗(cleanTextForTTS)并按句分段(splitTextForTTS),再按模式选择播报策略(清洗与分段的具体实现见下文第四节):
| 模式 | 策略 |
|---|---|
| 智能交互 | 边收边播:文本先入 ttsBuffer 攒字,攒到接近上限或流结束时才切段入队;runAudioQueue 串行播放(同一时刻只播一段,段间无缝),边听边出字,首段延迟低 |
| 专家问答 | 全文播报:message_end 后对完整回答分段顺序播放;retrieval_status/search/message_end 不参与播报 |
| 系统导览 | 本地 MP3 优先:段内配置了 audio 就播预生成音频(省 TTS 额度、发音更自然),无音频或加载失败(duration=0)回退实时 TTS |
静音与中断:
isExceptionAnswer:整段回答以Exception / ERROR / 错误 / 异常 + 冒号/空格开头(如额度用尽)时整轮静音;- 新提问 / 切换模式 / 停止播报 / 关闭面板 / 组件销毁时
cancelTTS()递增ttsToken,正在播放的序列检测到令牌变化立即中止; stopBroadcast()额外置位broadcastAborted,中断系统导览的段落循环与打字机。
四、TTS 文本清洗与分段(cleanTextForTTS / splitTextForTTS)
实现位置:
core/ttsText.js(纯函数,无会话状态依赖;同文件还含流式切句点resolveStreamingCut与异常回答判定isExceptionAnswer)。
大模型回答里常夹带大量 Markdown 标记、表情、表格等"适合看但不适合读"的内容。若直接整段送 TTS,不仅浪费字数额度,还会拖慢首字延迟。前端在播报前先做清洗再分段,核心价值有两点:
- 极大减少送转文本量,节约 TTS 转化成本:剔除表格、代码、表情、冗余符号后,真正进入 TTS 的字符数大幅降低,单次与累计额度消耗都更少。
- 配合流式边收边播,音频延迟更短、体验更好:清洗与分段在"边收边播"链路中实时进行——文本一到位就立即切段送转并播放,音频流随输入实时输出,无需等整段回答结束,首段播报延迟显著降低。
4.1 清洗 cleanTextForTTS —— 过滤干扰、只留正文
目标:把"适合看"的 Markdown 变成"适合读"的纯文本。
- 整块移除:代码块、HTML 表格、Markdown 表格(含无前后竖线的两列/多列表格变体)——这些对朗读无意义,且极易撑爆字数上限;
- 行内清理:
#标题符、<br>、耗时:xx秒类附属文案、加粗/斜体/行内代码/图片/链接标记(仅保留链接文字)、列表符、|分隔符; - 表情与特殊符号过滤:移除 emoji 及其他不适合朗读的特殊符号,避免 TTS 念出乱码或异常停顿;
- 正文衔接:保留的语句以中文逗号连接,保证朗读连贯、自然。
4.2 分段 splitTextForTTS —— 按句切分、避免超长/截断
清洗后,在 maxLen(默认取服务商 textLimited)范围内切段:
- 优先按句末标点切分:在
。!?.!?处断开,尽量不把一个句子拦腰切断; - 无标点硬切兜底:区间内没有句末标点时,按长度硬切,避免单次请求超长导致 TTS 失败;
- 与边收边播协同:段一就绪即刻入队播放,实现"边收文本、边出音频",首段播报延迟显著降低。
语音输入(ASR)、TTS 配置与播报控制开关见 语音输入功能。
五、数据格式与传输的示意图
5.1 后端返回的文本流
后端流式返回文本内容,为了防止空格被去掉,所以后端都加了一层双引号; 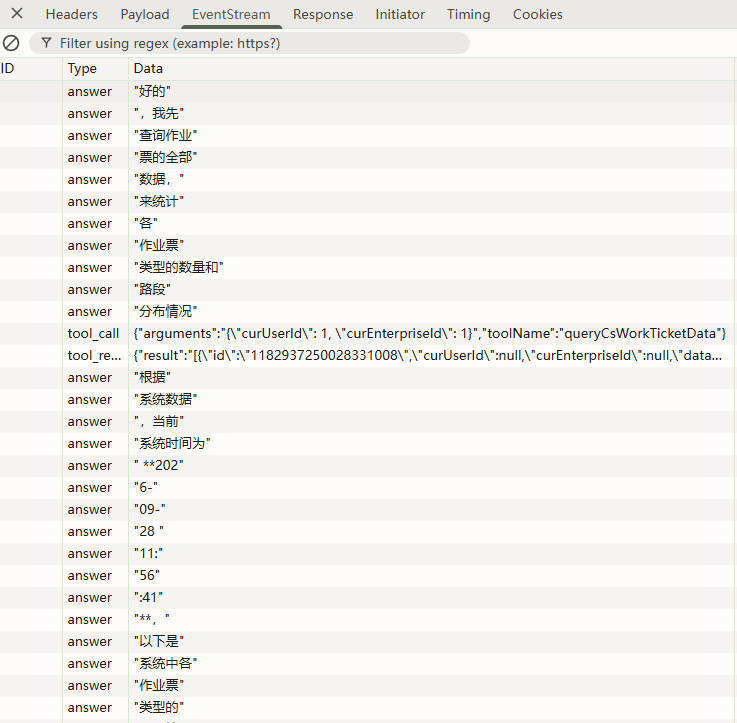
5.2 页面显示内容
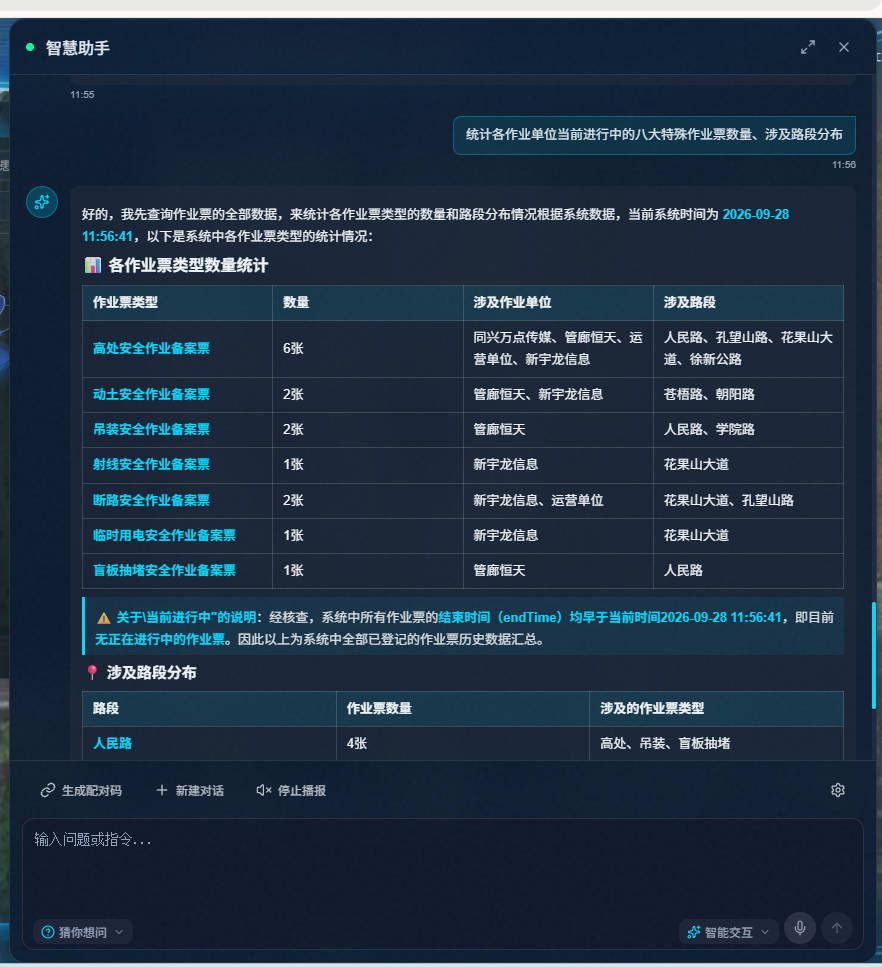
5.3 发给tts接口的文本
可以看到,流式文本中的表格、表情、符号等,均已被过滤掉了